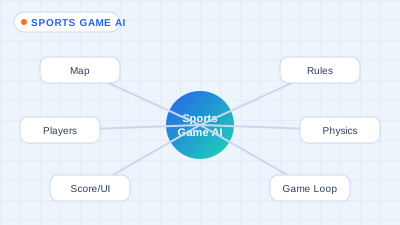
用户在输入框里写下一句话:“做一个三人制沙滩排球,海边,打到15分。”如果只是生成一张海滩球场的图片,这句话里的信息已经够用了。可如果目标是一个能玩的体育小游戏,模型至少要在这句话背后回答九个问题:这是什么运动、哪些规则照搬、场上几个人、场地多大、球怎么飞、比赛里会发生哪些事件、分数怎么记、屏幕上显示什么、一局游戏从哪里开始又在哪里结束。所谓“体育游戏生成大模型的理解能力”,落到工程上,就是它能不能把这九个问题逐一变成可输出、可检查的结构。
从一句话里拆出九个理解对象
这句提示词里明确写出来的只有三件事:运动类型是沙滩排球,人数是三人一队,目标分是15分。“海边”是场景描述,对玩法几乎没有约束。剩下的大部分内容都得由模型补齐,而补齐的前提是它知道沙滩排球的标准做法是什么。常见的沙滩排球正式比赛是每队2人,场地16米×8米,采用每球得分制,局分需要领先2分才能结束。用户写的“三人制”和“打到15分”都偏离了标准规则,模型需要把它们识别为“用户自定义改动”,而不是当成笔误纠正回去,也不能悄悄忽略。
在乐鱼体育的生成流程里,这一步的输出不是一段描述,而是一份带来源标记的配置:哪些值来自用户原话,哪些来自该运动的默认规则,哪些是模型推断的补充。来源不同,后面允许自动修改的程度也不同。
九项理解分别要交出什么
下面这张表是一个模拟示例,列出每一类对象在这个沙滩排球场景里至少要输出什么、系统又可以自动检查什么:
| 理解对象 | 模型需要输出 | 系统可以检查 |
|---|---|---|
| Sport | 运动类型、标准规则集版本、与标准的偏离项 | 偏离项是否都有来源标记 |
| Rule | 发球、触球次数、换发、得分、胜负判定 | 规则之间有无冲突,比赛能否结束 |
| Player | 每队人数、站位、能力属性、AI行为 | 人数与场地面积是否匹配 |
| Map | 场地尺寸、网高、边界、出界区 | 发球区、边界是否可达 |
| Physics | 球的质量、弹性、空气阻力、沙地减速 | 最大击球力度下球能否过网又不必然出界 |
| Event | 发球、拦网、出界、触网、连击 | 每个事件都有对应的判罚或计分结果 |
| Score | 得分规则、局分、封顶值 | 任何比分状态下都存在结束路径 |
| UI | 比分板、发球方提示、局点提示 | 界面显示与内部状态一致 |
| Game Loop | 开局、回合、换发、结算、重开 | 循环不会卡在某个状态 |
这张表的重点在右边一列。模型“理解了”规则,意味着规则能被检查;如果一项理解无法转成检查条件,它就只是一段看起来合理的文字。
Rule和Score:15分到底怎么才算打完
“打到15分”看起来最简单,实际最容易出问题。沙滩排球的局分要求领先2分,如果模型照搬这条规则,比分到14:14之后,比赛理论上可以一直拖下去。真人比赛里这不是问题,但在一个限定时长的小游戏里,两个水平接近的AI对手可能在16:16、17:17之间来回很久。模型需要主动发现这一点,并给出一个默认处理方式,比如“领先2分获胜,最高打到17分封顶”,同时把这个默认值显示给用户,允许他改成“先到15分直接获胜”。这就是规则理解和计分理解交叉的地方:只有同时知道胜负判定和比分上限,才能保证每个比分状态都有结束路径。
Player、Map和Physics:场地尺寸同时牵动三件事
标准场地是为每队2人设计的,半场8米×8米,64平方米。改成三人制后,如果场地不变,每人负责的面积从32平方米降到约21平方米,防守会明显变容易,回合拖长,比赛节奏也随之变慢。模型可以有两种处理:保持场地尺寸并提示“三人制下回合会更长”,或者按比例把场地加宽。无论哪种,它都必须意识到人数改了,场地和节奏都会跟着变。
物理参数也受场地牵连。球的初速度、弧线和沙地上的移动减速,决定了球员从底线跑到网前需要多久。以一个模拟参数为例,若球员在沙地上的最高移动速度设为每秒4米,从底线到网前8米需要约2秒,而一次高吊球的滞空时间如果只有1.5秒,那么吊网前几乎必然得分,比赛会退化成“谁先吊谁赢”。这类问题不是单独调球或单独调人能发现的,模型得把球员速度、场地尺寸和球的飞行时间放在一起看。
Event、UI和Game Loop:发生的事要能被记下、被看见
比赛事件是规则和计分之间的桥。触网、出界、超次触球(三人制下是否仍限三次触球,本身就需要向用户确认)、发球失误,每个事件都必须对应一个结果:谁得分、谁发球、是否需要回放提示。如果模型生成了“触网”事件却没有定义判罚,游戏运行时就会出现球员碰了网、比赛照常继续、界面却闪了一下提示的怪异情况。
UI理解的核心是“显示的状态和真实状态一致”。比分板显示14:13局点,内部状态却因为封顶规则认为已经进入最后一分,玩家就会困惑。Game Loop则把所有东西串成一圈:开局抽签决定发球方、每个回合从发球开始到死球结束、得分后更新比分和发球权、达到胜负条件后结算、提供再来一局。循环里任何一个状态没有出口,游戏就会卡住。
模拟对局:理解偏差会在哪里暴露
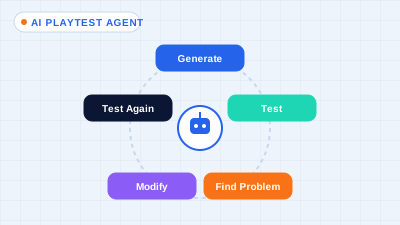
九项配置生成之后,系统会先让两支AI队伍在后台打若干局模拟比赛,再交给用户。在乐鱼体育的一次模拟测试中,跑200局后可能出现这样的记录:平均每局耗时超过预期一倍;有3局因为“球落在网正下方”的判定缺失而停在死球状态;发球方胜率达到68%。这三条分别指向三个理解对象:节奏问题来自Player和Map的组合,卡死来自Event定义不完整,发球优势则说明Physics里发球初速度偏大。关于这类后台测试的完整做法,可以参考AI自己玩一遍检查问题的讨论。
用户改一句话,哪些东西要重新理解
用户看完第一版,可能说:“改成四人制,场地大一点。”一个好的体育游戏生成大模型不会把九项全部推倒重来,而是判断影响范围:Player和Map必然要改,Physics中球员跑动参数可能需要微调,Rule和Score不受影响,UI只需要更新队员头像数量。修改之后,系统再跑一轮模拟,对比新旧两个版本的回合时长和胜率分布。如果四人制版本打起来反而更拖沓,用户可以直接回退到三人制的V1。
这也是乐鱼体育把“理解”拆成九类对象的原因:只有拆开,才能知道一次修改动了哪里,也才能把从地图、球队到规则的整条生成链路做成可以局部重算的结构。一个模型说自己理解体育,最好的证明不是它能把沙滩排球介绍得多详细,而是它生成的那一局比赛,在任何比分下都能打完,而且打完之后,用户能说清楚哪里想改、改完是什么结果。